Domain hfye.de kaufen?
Wir ziehen mit dem Projekt
hfye.de um.
Sind Sie am Kauf der Domain
hfye.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain hfye.de kaufen?
Wie funktionieren Web-Crawler und welche Rolle spielen sie beim Durchsuchen des Internets?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie sammeln Informationen über Webseiten, um Suchmaschinen bei der Indexierung und Bewertung von Websites zu unterstützen. Durch das regelmäßige Crawlen von Websites können Suchmaschinen aktuelle und relevante Informationen für die Nutzer bereitstellen. **
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **

Ähnliche Suchbegriffe für RC-Spidey-Web-Crawler
Top-Angebote
Produkte zum Begriff RC-Spidey-Web-Crawler:
-
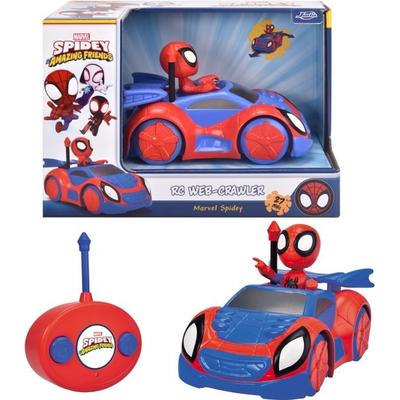
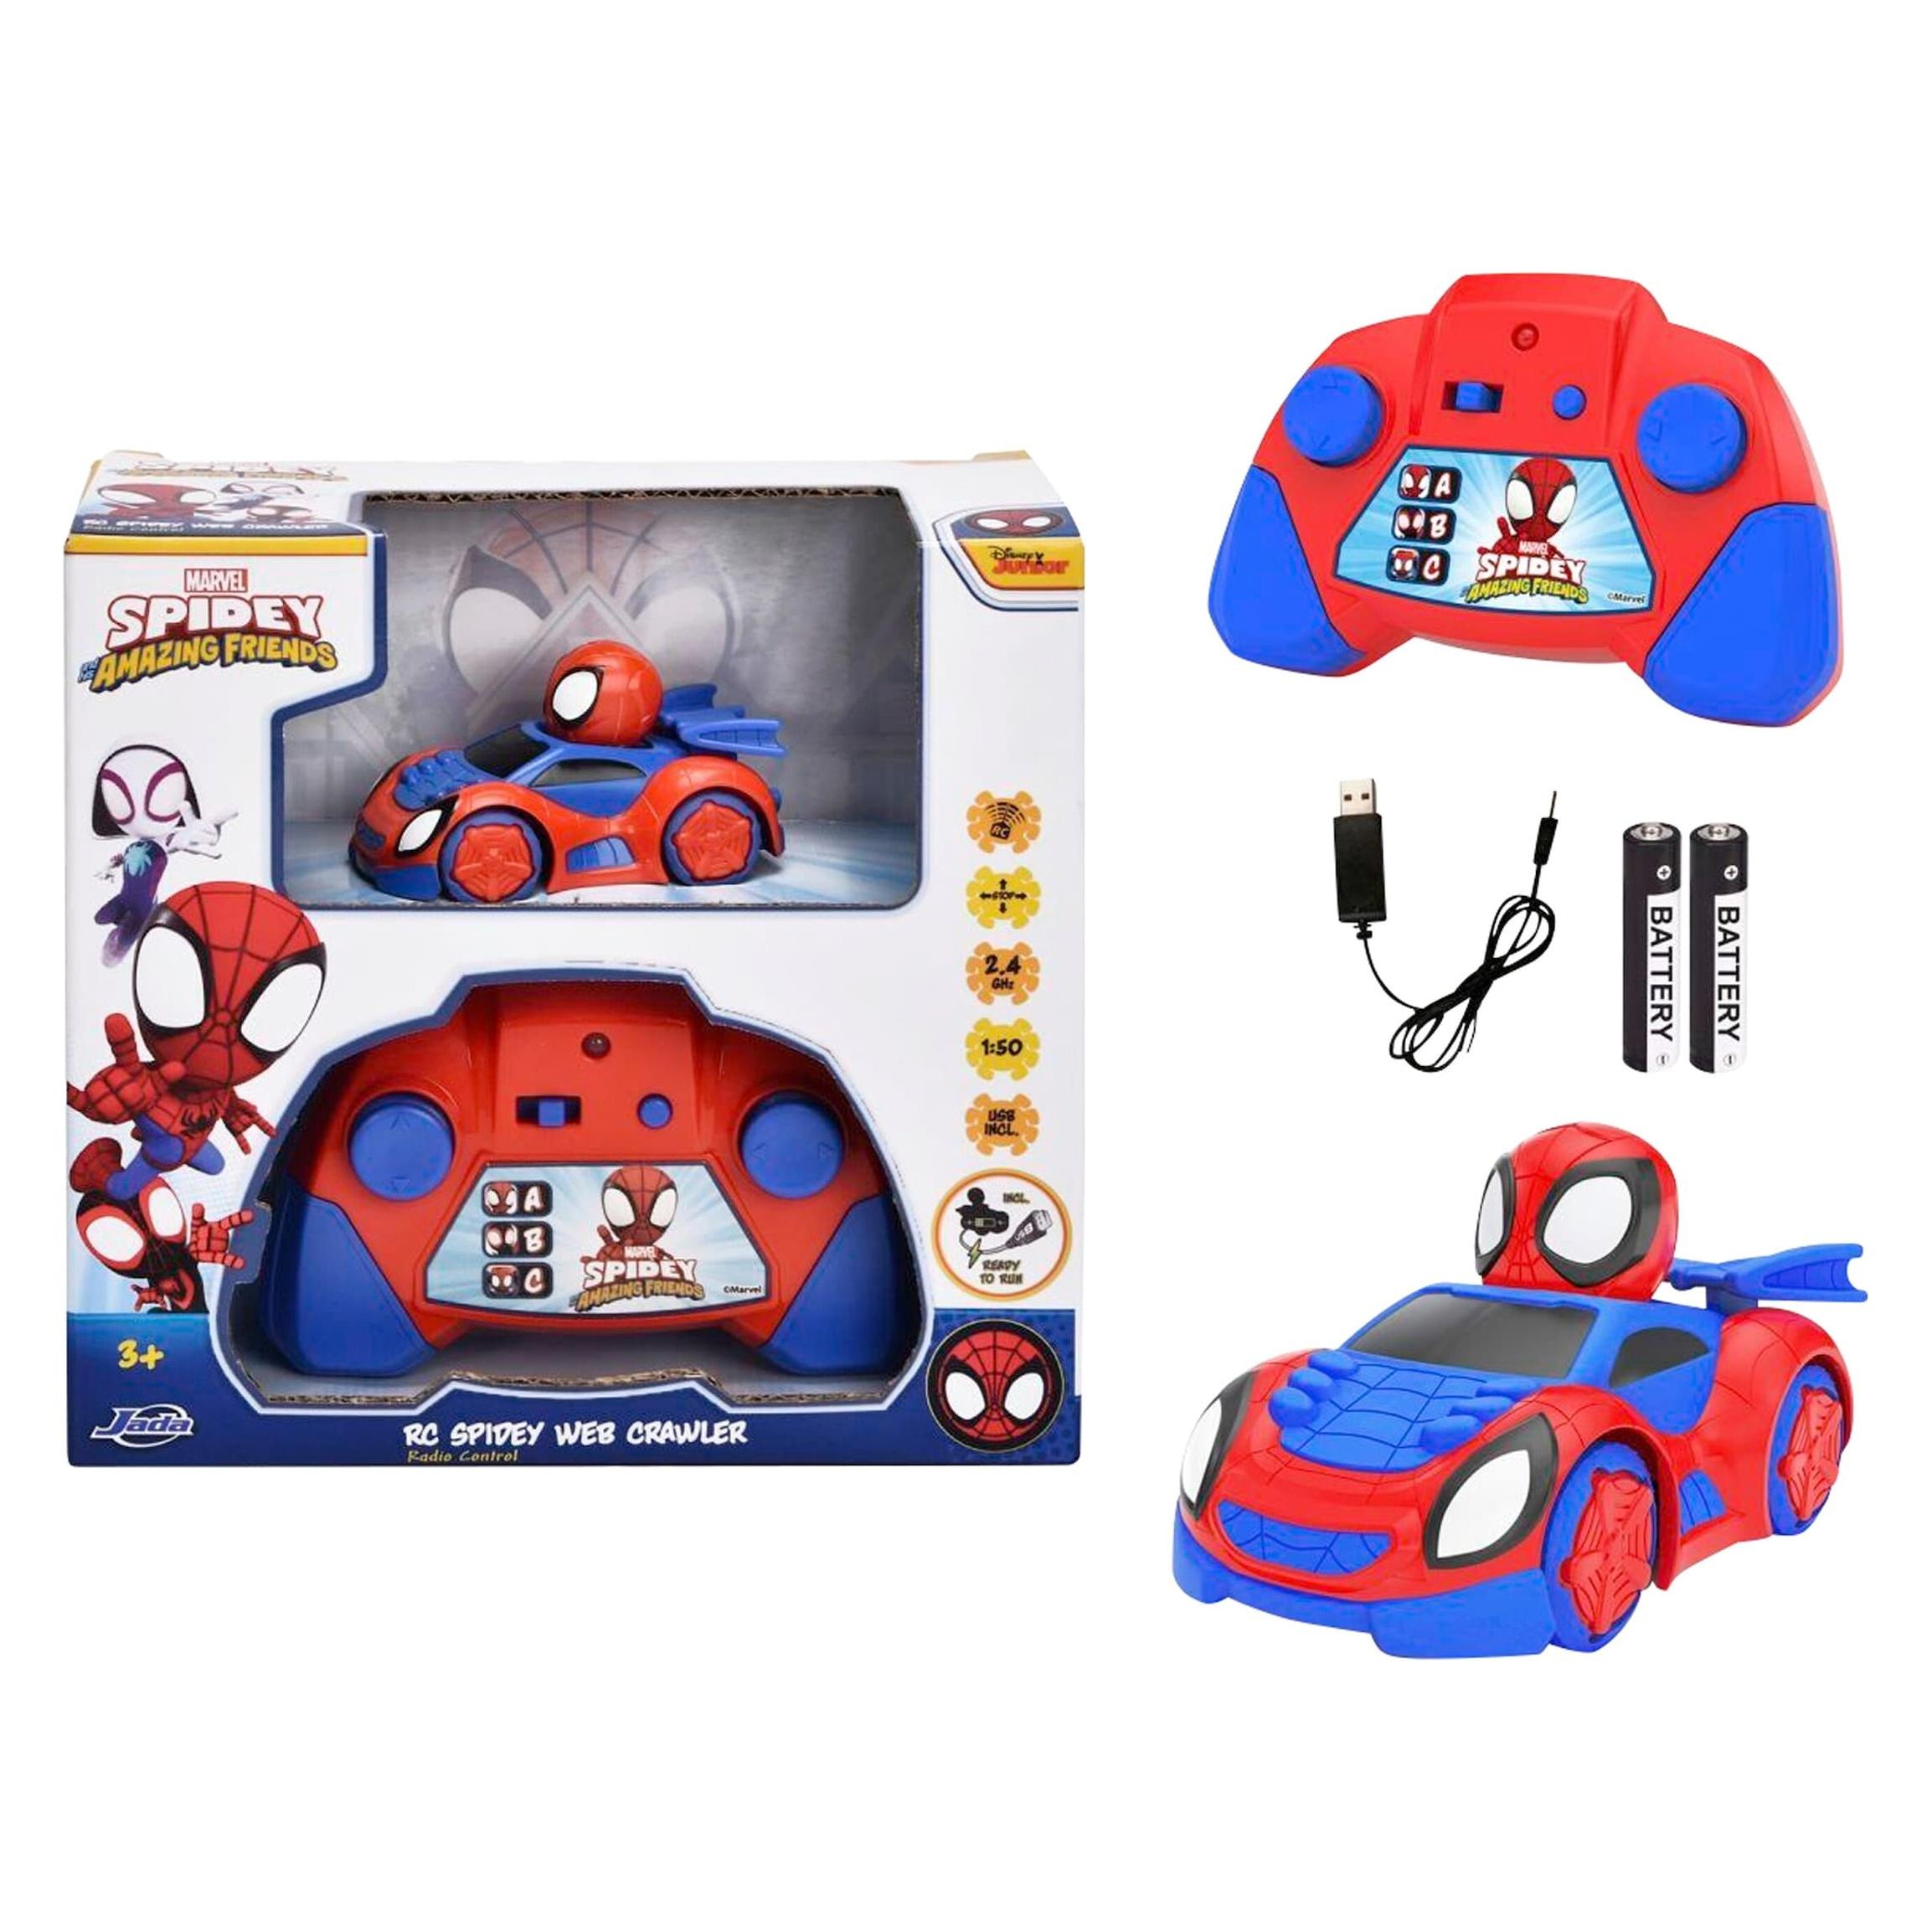
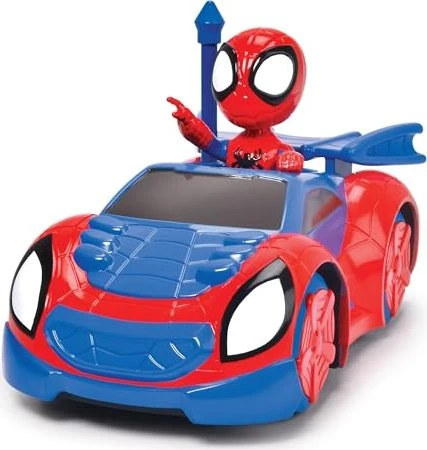
RC Spidey Web-Crawler 1:50Dickie Toys Rc Auto Spidey Web-crawler (8 Cm) - Ferngesteuertes Spielzeugauto Für Kinder Ab 3 Jahre Zu Marvels Spidey Und Seine Super-freunde, 6 Km/h, Inkl. Fernbedienung Und Batterien Rc Spidey Web-crawler: Ferngesteuertes Auto Von Dickie Toys •...25,99 €*Versand: 2,95 €Sichere Weiterleitung zum Anbieter
-
Panchekha, Pavel: Web Browser EngineeringWeb Browser Engineering , A working or budding software engineer always benefits from deeply understanding the platform their code runs on, and web browsers are the most common and widely-used platform there is. This book is the essential description of how they work and how that impacts web developers and other software engineers whose work touches the web. Readers of Web Browser Engineering will join the authors in building their own web browser, including rich visual effects, multithreaded architecture, JavaScript APIs, and comprehensive security policies. Web browser engines are filled with unique challenges, interesting algorithms, and clever optimizations. Building a browser is both easy and incredibly hard, both intentional and accidental, and everywhere you look, you see the evolution and history of the web wrapped up in one codebase. It's both fun, and endlessly interesting. This interactive and engaging book will be a unique source for any software engineer, computer scientist, web developer, or simply anyone with an interest in web browsers and how they work. This is an open access title available under the terms of a CC BY-NC-ND 4.0 International licence. It is free to read on the Oxford Academic platform and offered as a free PDF download from OUP and selected open access locations. , > , Erscheinungsjahr: 20241107, Produktform: Kartoniert, Autoren: Harrelson, Chris~Panchekha, Pavel, Seitenzahl/Blattzahl: 528, Themenüberschrift: COMPUTERS / Programming / General, Fachschema: Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Warengruppe: TB/Programmiersprachen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 234, Breite: 156, Höhe: 25, Gewicht: 860, Produktform: Kartoniert, Genre: Importe,47,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
RC Spidey Web Crawler 1:24Jada Toys Spidey Rc Web Crawler (17 Cm) - Ferngesteuertes Auto Zu Marvel Spidey Und Seine Super-freunde, Spielzeug-auto Mit Fernbedienung Für Kinder Ab 3 Jahre, Max. 6.5 Km/h • Offizielles Spidey Spielzeug - Inspiriert Von Den Abenteuern Der...29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie werden Crawler eingesetzt, um das Web zu durchsuchen und relevante Informationen zu sammeln?
Crawler sind automatisierte Programme, die das Web nach Inhalten durchsuchen, indem sie Links auf Webseiten folgen. Sie sammeln relevante Informationen, indem sie den Text auf den Seiten analysieren und Metadaten extrahieren. Die gesammelten Informationen werden dann in einer Datenbank gespeichert und für Suchmaschinen zur Indexierung verwendet. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Internetinhalten?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links folgen und Webseiten analysieren. Sie sammeln Informationen über Webseiten und senden sie an Suchmaschinen, die sie indexieren. Dadurch können Nutzer über Suchanfragen relevante Informationen im Internet finden. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie beim Indizieren von Websites für Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte indexieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Metadaten, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Ergebnisse für Suchanfragen zu liefern, indem sie auf die indizierten Informationen zugreifen. **

Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Websites in Suchmaschinen?
Web-Crawler sind automatisierte Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und Informationen sammeln. Sie analysieren den Inhalt, die Struktur und die Verlinkungen einer Website, um sie in Suchmaschinen zu indexieren. Dadurch können Suchmaschinen wie Google relevante und aktuelle Informationen für Suchanfragen bereitstellen. **
Was ist eine Web Domain?
Was ist eine Web Domain? Eine Web-Domain ist die eindeutige Adresse einer Website im Internet, die es Benutzern ermöglicht, auf die Website zuzugreifen. Sie besteht aus einem Namen und einer Endung, wie z.B. .com, .net oder .org. Die Domain wird in der Regel von einem Registrar registriert und muss jährlich verlängert werden. Eine Domain kann auch Subdomains enthalten, die zusätzliche Bereiche oder Seiten einer Website kennzeichnen. Insgesamt dient die Web-Domain als Identifikator und Wegweiser im World Wide Web. **
Top-Angebote
Produkte zum Begriff RC-Spidey-Web-Crawler:
-
Marvel RC Spidey Web CrawlerFerngesteuertes Auto RC Spidey Web Crawler bietet 1-Kanal-27 MHz-Steuerung und Fahrfunktionen für Vorwärtsfahren und Rückwärtslenken. Dieses Marvel Spidey RC-Auto ist für Kinder ab 3 Jahren konzipiert und hat eine Länge von 17 cm für einfaches Spielen drinnen und unkomplizierte Handhabung. Marvel Spidey Thema 1-Kanal-Steuerung 27 MHz Fernsteuerfrequenz Fährt vorwärts Lenkt rückwärts Länge: 17 cm Empfohlenes Alter: ab 3 Jahren Einfache Steuerung und kompakte Größe machen es zu einem spaßigen, leicht zu bedienenden Marvel Spidey Fahrzeug für den Alltag.29,72 €*Versand: 2,99 €Sichere Weiterleitung zum Anbieter
-
RC Spidey Web-Crawler 1:50Dickie Toys Rc Auto Spidey Web-crawler (8 Cm) - Ferngesteuertes Spielzeugauto Für Kinder Ab 3 Jahre Zu Marvels Spidey Und Seine Super-freunde, 6 Km/h, Inkl. Fernbedienung Und Batterien Rc Spidey Web-crawler: Ferngesteuertes Auto Von Dickie Toys •...25,99 €*Versand: 2,95 €Sichere Weiterleitung zum Anbieter
-
Panchekha, Pavel: Web Browser EngineeringWeb Browser Engineering , A working or budding software engineer always benefits from deeply understanding the platform their code runs on, and web browsers are the most common and widely-used platform there is. This book is the essential description of how they work and how that impacts web developers and other software engineers whose work touches the web. Readers of Web Browser Engineering will join the authors in building their own web browser, including rich visual effects, multithreaded architecture, JavaScript APIs, and comprehensive security policies. Web browser engines are filled with unique challenges, interesting algorithms, and clever optimizations. Building a browser is both easy and incredibly hard, both intentional and accidental, and everywhere you look, you see the evolution and history of the web wrapped up in one codebase. It's both fun, and endlessly interesting. This interactive and engaging book will be a unique source for any software engineer, computer scientist, web developer, or simply anyone with an interest in web browsers and how they work. This is an open access title available under the terms of a CC BY-NC-ND 4.0 International licence. It is free to read on the Oxford Academic platform and offered as a free PDF download from OUP and selected open access locations. , > , Erscheinungsjahr: 20241107, Produktform: Kartoniert, Autoren: Harrelson, Chris~Panchekha, Pavel, Seitenzahl/Blattzahl: 528, Themenüberschrift: COMPUTERS / Programming / General, Fachschema: Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Warengruppe: TB/Programmiersprachen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 234, Breite: 156, Höhe: 25, Gewicht: 860, Produktform: Kartoniert, Genre: Importe,47,42 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie beim Durchsuchen des Internets?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie sammeln Informationen über Webseiten, um Suchmaschinen bei der Indexierung und Bewertung von Websites zu unterstützen. Durch das regelmäßige Crawlen von Websites können Suchmaschinen aktuelle und relevante Informationen für die Nutzer bereitstellen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Webseiten?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und dabei Links folgen. Sie sammeln Informationen über Webseiten, wie z.B. Texte, Bilder und Meta-Daten. Diese Informationen werden dann von Suchmaschinen verwendet, um Webseiten zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie werden Crawler eingesetzt, um das Web zu durchsuchen und relevante Informationen zu sammeln?
Crawler sind automatisierte Programme, die das Web nach Inhalten durchsuchen, indem sie Links auf Webseiten folgen. Sie sammeln relevante Informationen, indem sie den Text auf den Seiten analysieren und Metadaten extrahieren. Die gesammelten Informationen werden dann in einer Datenbank gespeichert und für Suchmaschinen zur Indexierung verwendet. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen und Webseiten analysieren, um Informationen zu sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und für Suchmaschinen verfügbar zu machen. Durch das Crawlen und Indexieren von Webseiten können Suchmaschinen relevante Ergebnisse liefern, wenn Nutzer nach bestimmten Begriffen suchen. **
Ähnliche Suchbegriffe für RC-Spidey-Web-Crawler
-
RC Spidey Web Crawler 1:24Jada Toys Spidey Rc Web Crawler (17 Cm) - Ferngesteuertes Auto Zu Marvel Spidey Und Seine Super-freunde, Spielzeug-auto Mit Fernbedienung Für Kinder Ab 3 Jahre, Max. 6.5 Km/h • Offizielles Spidey Spielzeug - Inspiriert Von Den Abenteuern Der...29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
JADA TOYS 203225000 1: 18 RC Spidey Web RacerJada Toys Spidey RC Web Racer (27 cm) - ferngesteuertes Auto mit Licht zu MARVEL Spidey und seine Super-Freunde, Spielzeug-Auto mit Fernbedienung für Kinder ab 3 Jahre, max. 9 km/h Ferngesteuertes MARVEL Spidey RC Auto von Jada Toys • Radio Control Car „Spidey Web Racer“ mit 2-Kanal-Funk-Fernbedienung (2,4 GHz) • Länge: 27 cm, Maßstab: 1:18, 7.5-9.0 km/h • inkl. USB-Kabel & Batterien: 1x 3,2V-320 mAh-LiFe Akku, 2x 1,5V-R6, 3x 1,5V-R6, 2x 1,5V-R03 • Ladezeit: 90 min, Fahrzeit: 15 min • Altersempfehlung: Kinderspielzeug ab 3 Jahre • offizielle MARVEL Lizenz Ferngesteuerte Fahr-Action mit Spidey Erlebe mit dem Spidey Web Racer spannende Superfreunde-Abenteuer deiner Lieblings-Helden Peter Parker, Gwen Stacy und Miles Morales – besser bekannt als Superhelden Spidey, Ghost-Spider und Spin! Dank der 2-Kanal-Fernsteuerung (2,4 GHz) ist das Auto mit eingebauter Spidey Figur voll manövrierfähig in alle Richtungen und sorgt mithilfe der beiden Scheinwerfer-Lichter auch bei Dunkelheit für ordentlich Wirbel. Offiziell lizenziert & sofort startklar Durch die beeindruckende Spider-Man-Optik und die imposante Größe von 27 cm bringt das ferngesteuerte Spielzeugauto die fesselnde Welt aus der MARVEL Zeichentrickserie „Spidey and his Amazing Friends“ zu dir nach Hause! Das fantastische MARVEL RC Spidey Fahrzeug wird zusammen mit Fernbedienung, Batterien und USB-Kabel zum Aufladen geliefert und ist dadurch sofort startklar – das perfekte Geschenk & Spiderman-Spielzeug für Mädchen und Jungen ab 3 Jahren! Jada Toys – Hollywoods Helden als Spielzeuge und Sammlerstücke Batman, Fast & Furious, Harry Potter, Marvel, Minecraft oder Transformers: Mit Jada Toys holst du dir bekannte Hollywood-Größen als detailgetreue Nachbildungen von Filmfiguren und -autos in dein Wohnzimmer. Als führender Hersteller von Hollywood Actionfiguren und Modellautos kreieren wir seit über 20 Jahren hochwertige, detailgetreue Sammlerstücke für Kinder und Erwachsene.44,99 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Internetinhalten?
Web-Crawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links folgen und Webseiten analysieren. Sie sammeln Informationen über Webseiten und senden sie an Suchmaschinen, die sie indexieren. Dadurch können Nutzer über Suchanfragen relevante Informationen im Internet finden. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie beim Indizieren von Websites für Suchmaschinen?
Web-Crawler sind Programme, die das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte indexieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Metadaten, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Ergebnisse für Suchanfragen zu liefern, indem sie auf die indizierten Informationen zugreifen. **
-
Wie funktionieren Web-Crawler und welche Rolle spielen sie bei der Indexierung von Websites in Suchmaschinen?
Web-Crawler sind automatisierte Programme, die das Internet durchsuchen, indem sie von einer Webseite zur nächsten navigieren und Informationen sammeln. Sie analysieren den Inhalt, die Struktur und die Verlinkungen einer Website, um sie in Suchmaschinen zu indexieren. Dadurch können Suchmaschinen wie Google relevante und aktuelle Informationen für Suchanfragen bereitstellen. **
-
Was ist eine Web Domain?
Was ist eine Web Domain? Eine Web-Domain ist die eindeutige Adresse einer Website im Internet, die es Benutzern ermöglicht, auf die Website zuzugreifen. Sie besteht aus einem Namen und einer Endung, wie z.B. .com, .net oder .org. Die Domain wird in der Regel von einem Registrar registriert und muss jährlich verlängert werden. Eine Domain kann auch Subdomains enthalten, die zusätzliche Bereiche oder Seiten einer Website kennzeichnen. Insgesamt dient die Web-Domain als Identifikator und Wegweiser im World Wide Web. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.